Alianza global libera estructuras de 2.800 virus con IA para anticipar pandemias
NVIDIA y Google DeepMind liberan estructuras 3D de 2.800 virus para preparar al mundo frente a pandemias.
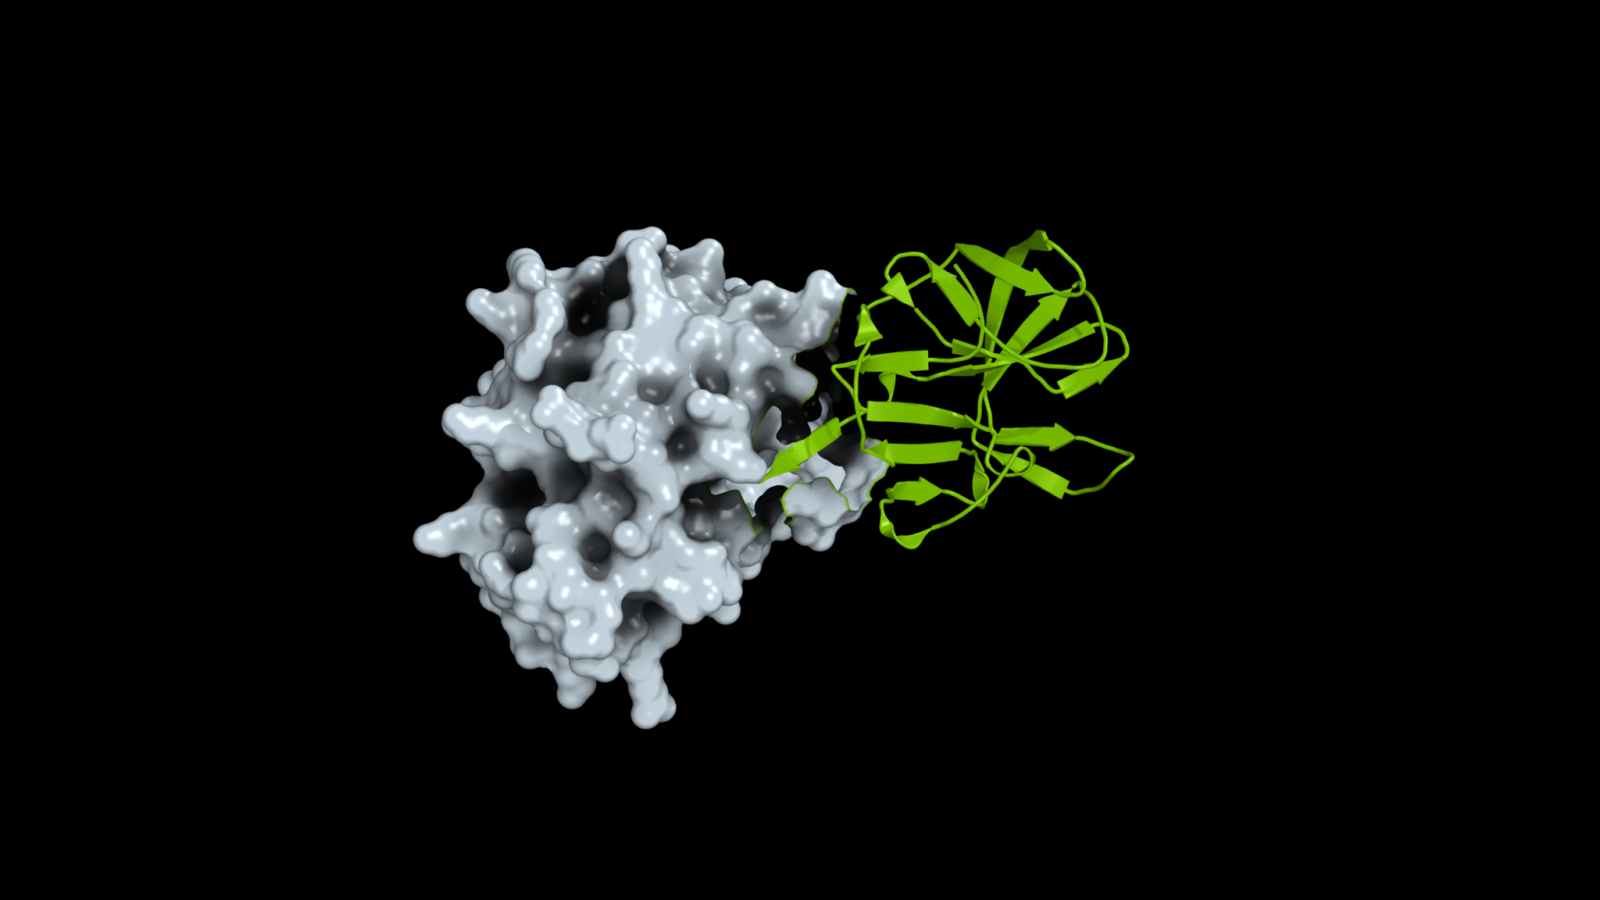
Cuando el COVID-19 golpeó, los científicos tenían una ventaja enorme: décadas de investigación sobre coronavirus les permitieron diseñar vacunas en tiempo récord. La próxima pandemia no tiene por qué ofrecer ese lujo. Para acortar esa brecha, NVIDIA se unió a una coalición global -junto a Google DeepMind y al Instituto Europeo de Bioinformática (EMBL-EBI)- y liberó estructuras tridimensionales predichas de los complejos de proteínas de más de 2.800 virus. Los datos son abiertos y están disponibles para cualquier científico en la Base de Datos AlphaFold.
Las estructuras se obtuvieron con AlphaFold2, el modelo de inteligencia artificial de Google DeepMind que predice cómo se pliegan las proteínas, y se optimizaron con el runtime de NVIDIA BioNeMo. Esta combinación permitió procesar miles de proteomas virales y predecir los complejos de proteínas, es decir, los grupos de moléculas que interactúan entre sí. Los métodos tradicionales para determinar estructuras proteicas -cristalizar proteínas y dispararles rayos X- pueden tomar años y costar miles de dólares por estructura. AlphaFold2, en cambio, predice una en minutos y se puede ejecutar en gran volumen.
¿Qué contiene el nuevo dataset?
El set abarca desde virus del resfrío común hasta amenazas emergentes como Mpox, y suma a la base AlphaFold, que ya tiene más de 260 millones de predicciones. Un 30% de las interacciones predichas son completamente nuevas: no aparecen en el Protein Data Bank, el principal repositorio de estructuras proteicas experimentales. Según Chris Dallago, líder del equipo de ciencia aplicada en biología digital de NVIDIA, “esta base de datos es un motor para generar hipótesis. Estamos permitiendo que biólogos y la comunidad de IA investiguen interacciones proteicas, no solo como moléculas individuales, sino como complejos, para que todo el campo avance”.
Risha Patel, de Google DeepMind, dijo: “Nuestra ambición con la Base de Datos AlphaFold siempre ha sido democratizar el acceso a la biología fundamental a gran escala. Esta colaboración para traer miles de complejos virales a la base equipará a científicos de todo el mundo con el conocimiento que necesitan para prepararse para futuros brotes”. Además, el acceso abierto es clave: Jo McEntyre, del EMBL-EBI, señaló que “hacer estos datos abiertos es fundamental para entender diagnósticos virales y desarrollar tratamientos y vacunas. También cubre virus poco estudiados y reduce las barreras para científicos en entornos con menos recursos”.
Prepararse para lo desconocido
La liberación coincide con una reunión de la Asamblea General de la ONU sobre prevención de pandemias. Un análisis del Centro para el Desarrollo Global estima que hay un 50% de probabilidades de que el mundo enfrente una pandemia tan severa como la COVID-19 antes de 2050. Joe Grove, profesor de virología molecular en la Universidad de Glasgow y colaborador, dijo: “Cuando ocurra la próxima pandemia, puede haber algo que salga de la nada y nos faltará el conocimiento que tuvimos para COVID. Lo que intentamos es acumular ese conocimiento con antelación”.
Para Chile, la utilidad es práctica: investigadores locales pueden descargar los datos sin costo y usarlos para estudiar virus, probar hipótesis o acelerar el desarrollo de fármacos. No necesitan un laboratorio de cristalografía de última generación, solo acceso a internet. La coalición incluye a la Coalición para las Innovaciones en Preparación ante Epidemias (CEPI), la Universidad Nacional de Seúl, la Universidad de Sungkyunkwan, el Instituto Suizo de Bioinformática y la Universidad de Glasgow. El pipeline de predicción de BioNeMo también se liberó abiertamente, así los investigadores pueden predecir estructuras para sus propios objetivos. Joe Grove, que vivió la falta de datos en su doctorado, añadió: “Cuando hice mi Ph.D. no había estructuras para ninguna de las proteínas que investigábamos. Era como trabajar en la oscuridad. Este dataset es una herramienta poderosa para los futuros investigadores, dándoles datos estructurales de alta calidad que acelerarán la ciencia fundamental”.
Con información de NVIDIA