NVIDIA aprieta cada byte de memoria para la IA que viene
Con HBM más caro y escaso, la compañía rediseña software y hardware para sacar más jugo a cada capa de almacenamiento.
La presión sobre la memoria de las GPUs no para de crecer. Modelos más grandes, contextos más largos y aplicaciones que actúan por su cuenta —las llamadas agentic— exigen cada vez más capacidad, justo cuando la oferta se ajusta y los precios suben. NVIDIA, el fabricante de los chips que mueven la inteligencia artificial, espera que esta tendencia se mantenga al menos en el corto plazo.
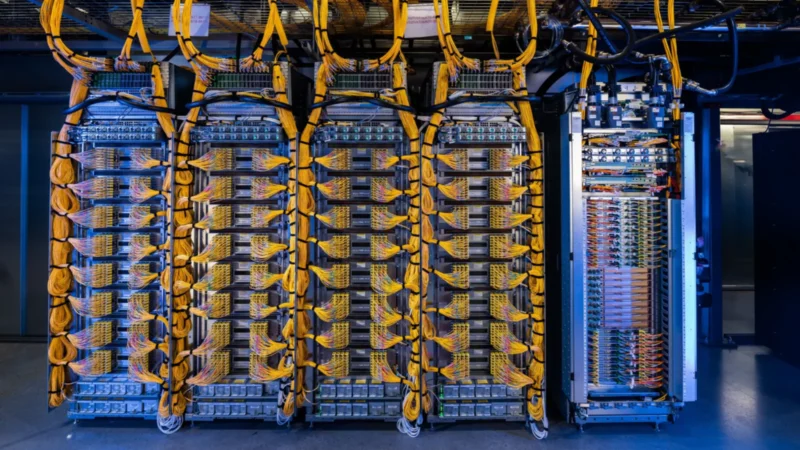
Para enfrentarlo, la empresa no apuesta solo a meter más memoria en cada GPU. Su estrategia es un rediseño completo —full-stack codesign— que integra GPUs, CPUs, redes, almacenamiento y software. La idea es que cada byte rinda al máximo en lo que llaman la fábrica de IA, una jerarquía donde la memoria más rápida y cara, la HBM (high-bandwidth memory), compite entre los pesos del modelo y el KV cache, que guarda el contexto de cada solicitud activa.
La memoria justa en el lugar justo
Agregar más HBM por GPU parece la salida obvia, pero no basta. La capacidad solo sirve si el ancho de banda puede mover los datos a tiempo. Es como tener una bodega enorme: si los muelles de carga son pocos, la mercadería no sale. Cuando cada usuario espera respuestas rápidas, llega un punto —el memory wall— donde la memoria no alcanza a alimentar el cómputo. Más HBM suma costo y consumo sin mejorar el rendimiento.
Por eso una fábrica de IA distribuye los datos en varios niveles. Arriba, la HBM de la GPU, velocísima pero escasa. Abajo, la memoria de la CPU, los SSD locales y el almacenamiento compartido, cada uno más lento pero más barato por bit. La gracia está en poner cada cosa donde corresponde y traerla de vuelta justo antes de que la GPU la necesite.
Trucos para estirar cada byte
NVIDIA ataca por varios frentes. Primero, encoge los pesos del modelo con el formato NVFP4, que ocupa la mitad que el FP8 usado en la generación anterior Hopper. Modelos como FLUX.2 [klein] de Black Forest Labs, Inkling de Thinking Machines Lab o el chileno Nemotron 3.5 Super VL ya se distribuyen con checkpoints en NVFP4, lo que muestra que los creadores de modelos están adoptando esta precisión de 4 bits para inferencia más rápida y con menos memoria.
Además, dentro de un sistema NVL72 los pesos se reparten entre hasta 72 GPUs, así cada una carga menos y deja espacio para el KV cache y más usuarios simultáneos. Segundo, comprime el KV cache también con NVFP4 y, cuando un contexto queda inactivo —por ejemplo, mientras una herramienta externa responde—, lo mueve a la CPU Vera o al nuevo almacenamiento CMX (context memory storage), que es mucho más barato que la HBM y está compartido entre servidores. El software Dynamo gestiona todo como un solo recurso, reutilizando contextos ya calculados en lugar de repetir el trabajo.
Tercero, para la búsqueda aumentada por recuperación (RAG), que agrega información empresarial a las consultas, NVIDIA usa embeddings compactos y mantiene el índice de búsqueda fuera de la HBM. Los modelos Nemotron Retriever generan representaciones numéricas que ocupan menos espacio.
¿Resultado? En la plataforma Blackwell Ultra y la futura Vera Rubin, la capacidad de HBM por GPU subió apenas un 3%, pero el rendimiento agéntico por dólar —medido por SemiAnalysis AgentX— creció hasta 30 veces. Para Chile, donde la adopción de IA recién empieza a escalar en empresas y servicios públicos, esta eficiencia importa: menos dependencia de hardware carísimo y más posibilidades de correr modelos avanzados sin tener que comprar decenas de GPUs nuevas.
Con información de NVIDIA