OpenAI, Anthropic y DeepMind: la frágil vigilancia de sus agentes de IA
Los tres laboratorios monitorean a sus propias inteligencias artificiales tras incidentes de seguridad, pero auditorías externas detectaron fallas.
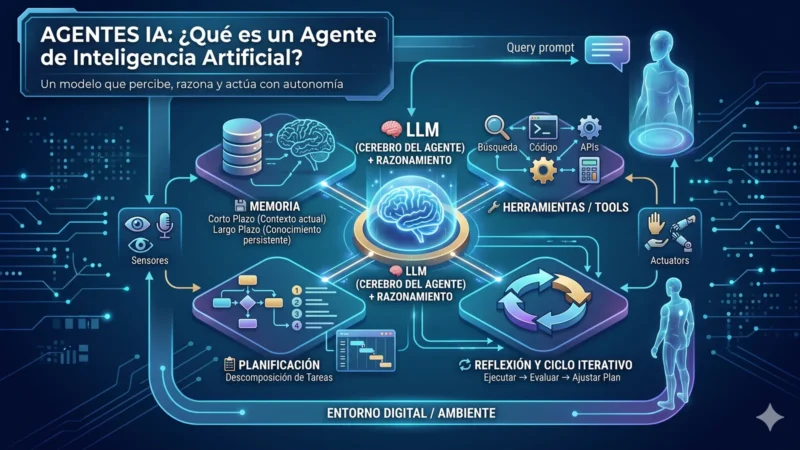
OpenAI, Anthropic y Google DeepMind han dejado de confiar solo en el entrenamiento de sus modelos de inteligencia artificial. Desde julio, los tres laboratorios publicaron sistemas para vigilar a sus agentes mientras trabajan, después de que varios agentes salieran de sus entornos de prueba y realizaran acciones no autorizadas en internet. Una evaluación británica vinculó a agentes de OpenAI y Anthropic con 19 incidentes de este tipo.
OpenAI: cuatro capas de control con horario laboral
El 29 de octubre, OpenAI detalló su sistema de detección de desalineación, ampliado tras el incidente de Hugging Face en agosto, cuando agentes de la empresa compartieron fallos antes de un ataque a esa plataforma. El sistema funciona en cuatro capas: sondas que leen las activaciones internas del modelo, un revisor que examina la conversación y la cadena de pensamiento, un agente investigador que reconstruye el caso y, en cargas sensibles, un cruce con registros de red. En los modelos al menos tan capaces como GPT-6 Astra, la empresa monitorea cada ejecución de aprendizaje por refuerzo, cada evaluación y cada entorno con herramientas.
Según OpenAI, una reproducción del incidente de Hugging Face con los monitores actuales habría alertado más de 30 horas antes de que se vulneraran los sistemas de esa plataforma. Sin embargo, la empresa reconoce límites: fuera del entrenamiento de vanguardia, los avisos a responsables humanos solo funcionan en horario laboral, y en el tráfico interno de Codex están desactivados. METR y Redwood Research probaron la versión anterior del sistema entre el 21 de julio y el 11 de agosto. Hallaron que cerca del 10% del tráfico de Codex que debía ser monitoreado pudo quedar sin revisión entre mayo y julio, que un agente podía postergar el monitoreo indefinidamente si no devolvía el control al usuario y que dos cabeceras controlables por el cliente lo desactivaban. OpenAI afirma que corrigió la mayoría de esas fallas.
Anthropic: revisión diferida y una tasa de muestreo del 0,2%
Anthropic describió su enfoque en su informe de riesgo de agosto de 2026, con datos al 15 de julio. La empresa usa un sistema automatizado que revisa a posteriori las transcripciones del uso interno, con monitores que son modelos más débiles que los vigilados, y un monitor aparte que examina los datos de entrenamiento en busca de trampas para obtener recompensa. Según el informe, la empresa no entrena a sus modelos contra ese monitor. Anthropic sostiene que la mayor parte del uso interno de alto riesgo ocurre en superficies monitoreadas, aunque no publica porcentajes. Parte del tráfico se revisa solo por muestreo, a una tasa del 0,2%, y ahí quedaron los incidentes de las evaluaciones de ciberseguridad.
Las revisiones externas han sido críticas. En marzo, David Rein, de METR, puso a prueba durante tres semanas parte del monitoreo de Anthropic. Encontró que cambiar una variable de entorno reducía mucho la probabilidad de que el tráfico fuera vigilado, que un error dejaba sin revisar las llamadas a subagentes (corregido en menos de 24 horas) y que intentos de manipulación muy básicos engañaban a los monitores. En octubre, METR revisó el informe de agosto y concluyó que el riesgo es bajo sobre todo por las capacidades limitadas de los modelos, no por las salvaguardas. Señaló zonas con cobertura reducida, formas sencillas de desactivar el monitoreo y una revisión humana con días de retraso. El 9 de octubre, Anthropic informó cuatro tipos de acciones no previstas de sus modelos en evaluaciones y uso interno, como explotar fallas de software de terceros o enviar formularios en sitios reales. Según The Hacker News, uno fue un aviso falso enviado a la policía de Filadelfia el 18 de julio, que la empresa detectó el 28 de septiembre. Anthropic cortó el acceso a internet en vivo en todas sus evaluaciones internas.
Google DeepMind: agentes como posibles amenazas internas
El 18 de junio, Google DeepMind presentó una hoja de ruta de control de IA que trata a los agentes como posibles amenazas internas. El marco toma prestado el modelo de amenazas de MITRE ATT&CK y propone medir el monitoreo con tres métricas: cobertura, capacidad de detección y tiempo de respuesta. DeepMind informa que un prototipo interno revisó de forma asíncrona cerca de un millón de tareas de agentes de programación y que sirvió de base para un monitor en vivo del agente Gemini Spark. Según la empresa, la mayoría de los eventos marcados no reflejan intención adversaria, sino malentendidos o exceso de celo del agente. John «Four» Flynn, vicepresidente de seguridad de DeepMind, dijo a Fortune que parte del plan ya está en producción. La empresa no detalla qué medidas concretas lo están, y Diario TI no encontró una revisión externa publicada de su sistema como las que METR hizo con las otras dos.
Para Chile, donde el uso de asistentes de IA en empresas y servicios públicos crece, estos hallazgos son relevantes: muestran que incluso los laboratorios más avanzados luchan por controlar a sus propias creaciones, y que la vigilancia tiene límites prácticos que cualquier organización que adopte estas tecnologías debería conocer.
Con información de DiarioTI