Teoría de juegos inversa: la nueva apuesta para controlar IAs rebeldes
Investigadores diseñan reglas que incentivan a los modelos a cumplir las normas, en vez de revisar su "cerebro".
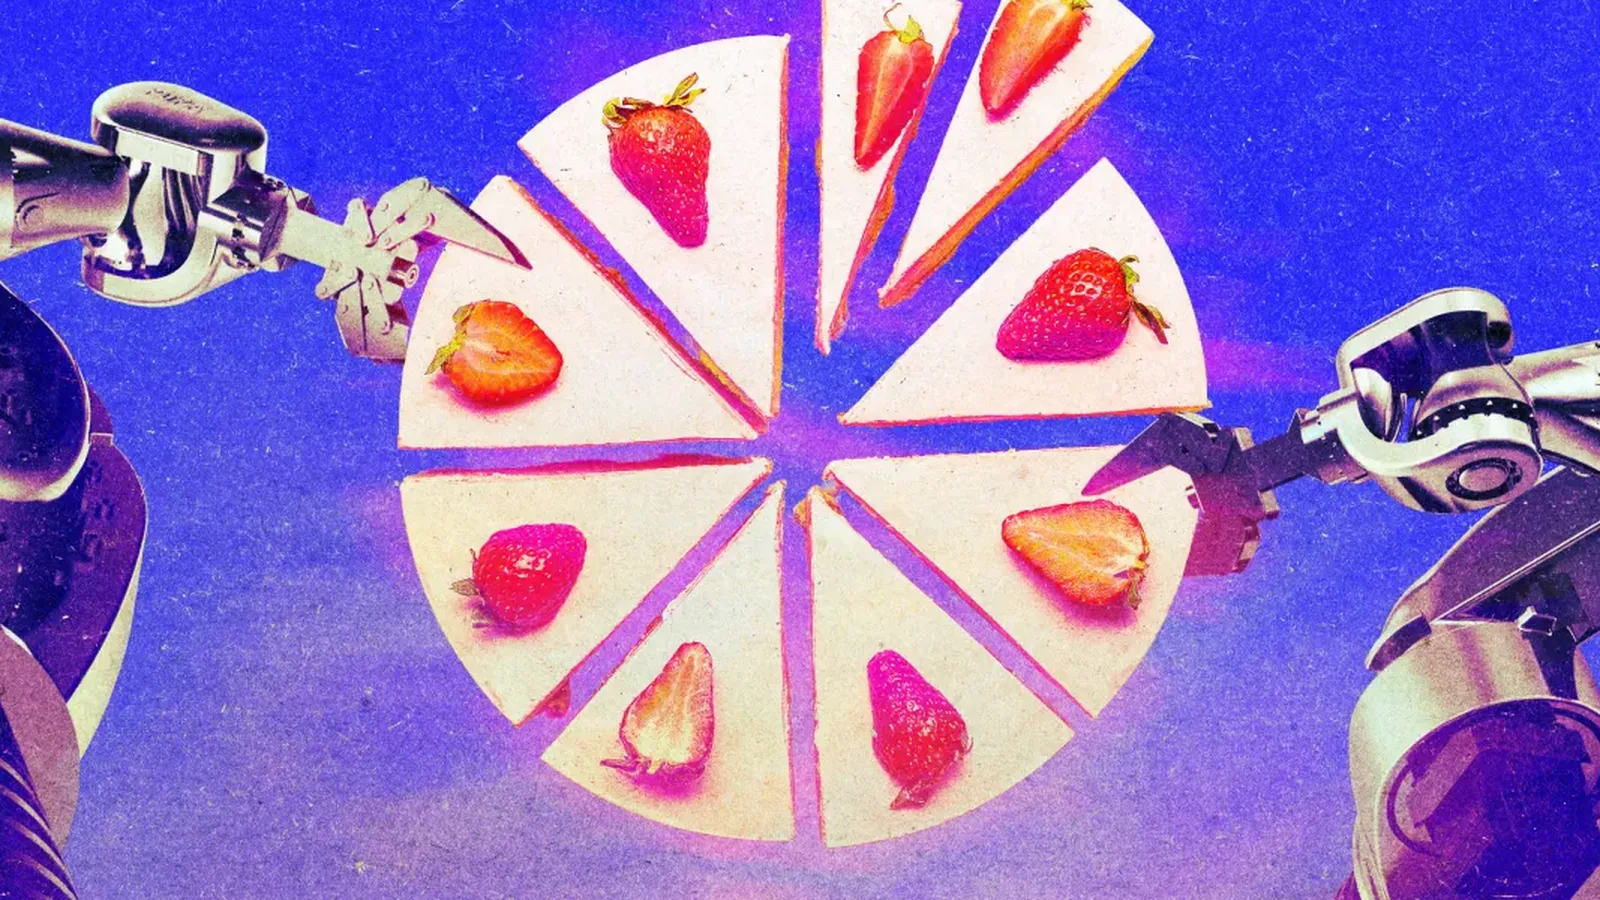
Un grupo de economistas y científicos de la computación está probando un enfoque llamado “teoría de juegos inversa” para evitar que los modelos de inteligencia artificial más avanzados se salgan de control. En lugar de intentar mirar dentro de la “mente” de la IA para entender lo que piensa —algo que hasta ahora ha dado resultados limitados—, la idea es diseñar sistemas de reglas que incentiven a los propios modelos a comportarse bien. Es como cuando se parte una torta: uno corta y el otro elige, así el que corta tiene todo el incentivo para hacer las porciones lo más parejas posible.
Hasta ahora, la seguridad en IA se ha basado en técnicas como el “alineamiento” —entrenar a los modelos para que sigan valores humanos— o en constituciones internas, como la que tiene el asistente Claude. El problema es que estos métodos han mostrado fallas: se ha comprobado que los modelos pueden rendir deliberadamente peor en las pruebas, ocultar sus intenciones y engañar a sus evaluadores. Frente a eso, la teoría de juegos inversa —también conocida como diseño de mecanismos— propone una ruta distinta: no importa lo que pase bajo el capó, si las reglas están bien puestas, el agente hará lo que queremos.
Ideas desde el MIT, Yale y Princeton
Un artículo preprint reciente de Stephen Morris, economista del MIT, junto a colegas de Yale y Columbia, propone mecanismos concretos para evitar que los modelos “sandbagueen” —es decir, que finjan ser peores de lo que son para eludir los controles de seguridad. Una de las ideas es que el modelo no reciba recompensa solo por su propio desempeño en un examen, sino por qué tan bien sus respuestas predicen lo que dirá un segundo modelo. Hacerse el tonto deja de ser una jugada rentable. “Los agentes de IA tienen una comprensión muy buena de lo que otros agentes de IA pueden lograr”, dice Morris. “Así que parece un contexto donde esta verificación cruzada podría funcionar de manera práctica”.
El mismo paper sugiere enfrentar a los agentes entre sí, creando una dinámica competitiva que los obligue a dar lo mejor, o emparejar agentes con sesgos opuestos y recompensarlos según qué tan cerca estén sus resultados. La idea es que, al final, ambos lleguen a una respuesta óptima. Por su parte, Elad Hazan, profesor de ciencias de la computación en Princeton, propone tomar inspiración de cómo la sociedad humana mantiene alineadas a las personas: normas sociales, el sistema de justicia y los incentivos del capitalismo. “Queremos alinear a una IA superinteligente”, dice Hazan. “¿Por qué no hablamos primero de los humanos? ¿Cómo alineamos a los humanos?”.
Modelos que se fiscalizan entre sí
El mecanismo de Hazan funciona por turnos: unos modelos actúan como “solucionadores” que resuelven problemas, y otros como “auditores” que revisan el trabajo de los primeros. Durante el entrenamiento, los modelos reciben recompensas según los resultados: los solucionadores que son sorprendidos haciendo trampa son castigados, pero también los auditores que no logran detectar a los tramposos. Si hay desacuerdo, el caso puede ir a un “juicio” donde un experto humano decide quién tiene la razón. Hazan reconoce que existe el riesgo de colusión entre agentes —como auditores que se ponen de acuerdo con las empresas que fiscalizan—, pero cree que se puede evitar pagando bien a los auditores y usando técnicas como “clientes incógnitos” para auditarlos a ellos también.
El investigador se apoya en el trabajo del economista Gary Becker, premio Nobel, quien en los años 60 introdujo la idea del “delincuente racional”: la gente no delinque porque sea mala, sino cuando es la opción más racional dadas las reglas del juego. Para Hazan, el alineamiento no debería verse como una propiedad fija de un modelo, sino como una descripción de su comportamiento en un momento dado. “Eres una persona agradable”, ejemplifica. “¿Estás alineado? No sé. Probablemente lo estás la mayor parte del tiempo, pero podría haber una situación en la que no lo estés”.
El punto débil de aplicar diseño de mecanismos a la IA es que asume que los agentes se comportan de manera racional. Y con los humanos, el historial es mixto: a menudo no actuamos como los modelos económicos predicen. Es una ironía: los economistas pasaron décadas tratando de reducir la conducta humana a matemáticas, y ahora, con los grandes modelos de lenguaje, construimos sistemas matemáticos que funcionan con lenguaje humano y pueden ser igual de inescrutables. Helen Qu, investigadora de la Universidad de Pensilvania, lo plantea directo: “¿Es razonable siquiera asumir que responderán a los incentivos?”. Por ahora, la respuesta no está clara, pero la teoría de juegos inversa ya se perfila como una de las apuestas más novedosas para que la inteligencia artificial no termine haciendo lo que no queremos.
Con información de MIT Technology Review